Wissensmanagement mit KI 2026: Firmenwissen sicher nutzen
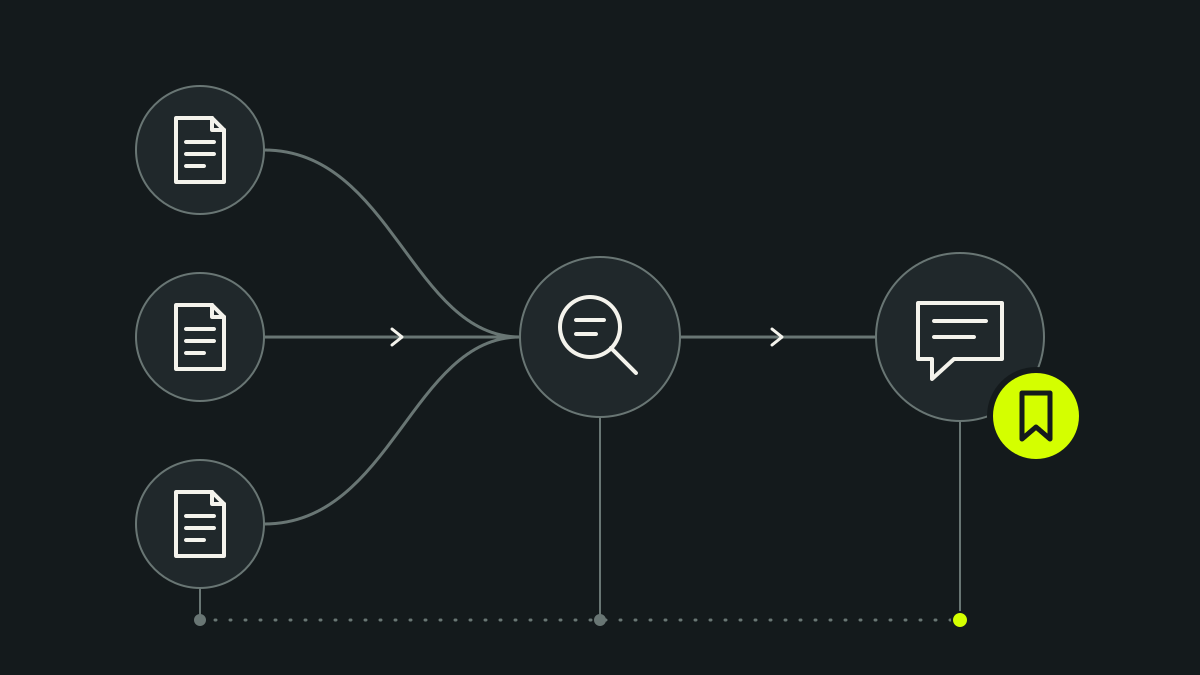
Wissensmanagement mit KI heißt: Ein internes System beantwortet Fragen Ihres Teams aus Ihren eigenen Dokumenten und nennt die Quelle. Technisch steckt meist RAG dahinter. Das System sucht zuerst passende Textstellen und formuliert erst dann die Antwort. Die Datenschutzkonferenz sieht darin Vorteile für Richtigkeit und Vertraulichkeit, wenn Dokumente und Rechte gepflegt sind.1
Inhalt14 Kapitel
„Ein internes KI-System ist nur so gut wie die Dokumente, die es kennt, und die Rechte, die es beachtet. Deshalb klären wir zuerst, welches Wissen hinein soll und wer was sehen darf. Erst dann kommt die Technik, und jede Antwort nennt ihre Quelle, damit Ihr Team sie nachvollziehen kann.“
Benjamin Wünsche, CEO & SystemarchitektAus der PraxisWas ist Wissensmanagement mit KI?
Wer im Wissensmanagement KI einsetzt, macht vorhandenes Firmenwissen abfragbar. Ein KI-gestütztes Wissensmanagement-Tool beantwortet Fragen in normaler Sprache aus Ihren eigenen Unterlagen. Zu jeder Antwort zeigt es, aus welchem Dokument sie stammt.1
Das unterscheidet es von den Werkzeugen, die Sie kennen. Eine Dateisuche findet Dokumente, lesen müssen Sie diese selbst. Ein Wiki sammelt Wissen, aber nur, wenn jemand es pflegt und andere darin nachschlagen. Das KI-System liest für Sie die passenden Abschnitte und formuliert daraus eine Antwort.
Die Datenschutzkonferenz, in der sich die Aufsichtsbehörden von Bund und Ländern abstimmen, hat im Oktober 2025 eine eigene Orientierungshilfe zu solchen Systemen veröffentlicht. Sie richtet sich an Unternehmen und Behörden. Dieser Beitrag stützt sich an vielen Stellen darauf.12
Siehe auch
Wo KI im Mittelstand Zeit spartWelche Fragen beantwortet ein internes KI-System im Alltag?
Typisch sind die Fragen, die heute immer bei denselben Kolleginnen und Kollegen landen. Welche Konditionen gelten für diesen Bestandskunden? Wo steht, wie die Anlage nach einer Störung wieder anläuft? Jede einzelne Frage kostet wenig Zeit, aber sie unterbricht die Arbeit derer, die es wissen.
Besonders spürbar wird das bei neuen Mitarbeitenden und in der Urlaubsvertretung. Wer neu ist, weiß noch nicht, wen er fragen soll. Wer vertritt, findet die Unterlagen der Kollegin nicht. Ein internes System hilft in beiden Fällen, weil es die Antwort aus den Unterlagen holt und nicht vom richtigen Ansprechpartner abhängt.
Ein fiktives Beispiel: Ein Maschinenbauer bindet Handbücher und frühere Servicefälle an. Der Service fragt nach einem Fehlerbild und bekommt die Antwort mit Verweis auf Seite und Fassung des Handbuchs.
Tabelle seitlich scrollen
| Bereich | Beispielfrage | Quelle im Unternehmen |
|---|---|---|
| Vertrieb | Welche Konditionen gelten für diesen Bestandskunden? | Preisliste, Rahmenverträge |
| Service | Was bedeutet dieses Fehlerbild und was ist zu tun? | Handbuch, frühere Servicefälle |
| Verwaltung | Wie rechne ich eine Dienstreise ab? | Interne Reisekostenrichtlinie |
| Projekte | Haben wir so etwas schon einmal angeboten? | Frühere Angebote |
| Neu im Team | Wer ist für Reklamationen zuständig? | Organigramm, Prozessbeschreibungen |
Wie funktioniert RAG, einfach erklärt?
RAG steht für Retrieval Augmented Generation, frei übersetzt: Antworten mit vorheriger Suche. Bevor das Sprachmodell antwortet, ergänzt das System Ihre Frage um passende Textstellen aus Ihren Dokumenten. Das Modell bekommt also einen kleinen Stapel Unterlagen mit auf den Weg.1
Damit die Suche funktioniert, werden Ihre Dokumente vorher aufbereitet. Das System zerlegt sie in kurze Abschnitte und übersetzt jeden Abschnitt in eine Zahlenfolge, die seine Bedeutung abbildet. Diese Zahlenfolgen heißen Vektoren und liegen zusammen mit den Abschnitten in einer eigenen Datenbank.1
Stellt jemand eine Frage, wird auch sie in einen Vektor übersetzt. Ein Suchbaustein, der Retriever, holt die Abschnitte mit der größten inhaltlichen Nähe. Gesucht wird nach Bedeutung, gleiche Wörter braucht es dafür nicht.1
Frage und Abschnitte gehen dann gemeinsam an das Sprachmodell. Im Idealfall steuert das Modell nur die Sprache bei, das Wissen stammt aus Ihren Dokumenten. Ganz erreicht wird dieser Idealfall laut Datenschutzkonferenz derzeit nicht immer.1
| Baustein | Aufgabe |
|---|---|
| Datenaufbereitung | Zerlegt Dokumente in kurze Abschnitte und entfernt Störendes wie Kopf- und Fußzeilen |
| Embedding-Modell | Übersetzt Abschnitte und Fragen in Vektoren |
| Vektordatenbank | Speichert die Abschnitte zusammen mit ihren Vektoren |
| Retriever | Sucht die Abschnitte, die inhaltlich zur Frage passen |
| Sprachmodell | Formuliert aus Frage und Abschnitten die Antwort |
Quellen zur Tabelle1
Warum antwortet ein RAG-System verlässlicher als ein normaler Chat?
Ein Sprachmodell ohne Zugriff auf Ihre Unterlagen kennt Ihren Betrieb nicht. Fragt man es trotzdem, erzeugt es im ungünstigen Fall eine Antwort, die plausibel klingt und falsch ist. Fachleute nennen das Halluzination.1
Mit RAG stützt sich die Antwort auf Ihre Dokumente. Laut Datenschutzkonferenz kann das Halluzinationen und unrichtige Angaben über Personen verringern. Ausschließen lassen sich Fehler damit nicht.1
Ein zweiter Vorteil zeigt sich, wenn etwas falsch ist. Was ein Modell im Training gelernt hat, lässt sich nicht gezielt korrigieren. Ein veraltetes Dokument dagegen ersetzen oder löschen Sie, und ab dann antwortet das System anders.1
Damit das gelingt, nennt die Datenschutzkonferenz mehrere Voraussetzungen. Die folgenden vier betreffen jedes System, ob gekauft oder selbst gebaut.1
- Gute Dokumente: Die Antworten sind nur so aktuell und vollständig wie die Unterlagen dahinter.
- Saubere Aufbereitung: Kopf- und Fußzeilen und Seitenzahlen werden vorher entfernt, jeder Abschnitt enthält einen abgeschlossenen Gedanken.
- Passende Sprache: Bei deutschen Dokumenten sollte das Embedding-Modell mit deutschen Texten trainiert sein.
- Klare Anweisung: Eine feste Systemanweisung verpflichtet das Modell, nur aus den gefundenen Quellen zu antworten.
Wo liegen die Grenzen von RAG?
Das System kann dem Modell nur eine begrenzte Menge Text mitgeben. Lange Dokumente stören dabei wenig, solange sie sich sinnvoll in Abschnitte teilen lassen. Schwierig wird es bei Zusammenhängen, die sich über viele Seiten ziehen.1
Ein Beispiel ist eine Wenn-dann-Regel, deren Bedingung am Anfang und deren Folge am Ende eines langen Vertrags steht. Die Suche findet dann womöglich nur einen Teil, und die Antwort bleibt unvollständig. Ansätze mit KI-Agenten, die mehrmals nachsuchen, sollen das ausgleichen.1
Am Sprachmodell selbst ändert RAG nichts. Ein Modell, das rechtswidrig trainiert wurde, bleibt auch im RAG-System rechtswidrig trainiert. Nachvollziehen lässt sich, welche Abschnitte in eine Antwort eingeflossen sind. Wie das Modell daraus seine Sätze bildet, bleibt dagegen undurchsichtig.1
Vorsicht auch bei der Websuche. Bindet ein System zusätzlich das Internet an, lassen sich Rechtmäßigkeit, Eignung und Richtigkeit der Daten laut Datenschutzkonferenz regelmäßig nicht ausreichend sicherstellen. Interne Quellen sollten dann Vorrang haben.1
Siehe auch
Was KI-Agenten im Büro übernehmenWelche Dokumente gehören in das System und welche nicht?
Hinein gehören Unterlagen, deren Herkunft Sie kennen. Dokumente aus unbekannten oder nicht vertrauenswürdigen Quellen sollten laut Datenschutzkonferenz draußen bleiben. Gibt es von einem Dokument mehrere Fassungen, kommt nur die gültige hinein.1
Personenbezogene Daten, die für die Antworten nicht nötig sind, entfernen oder anonymisieren Sie vor dem Einlesen. Das betrifft etwa Namen in Protokollen oder Unterschriften unter Vorlagen. Je weniger solcher Daten im System liegen, desto weniger müssen Sie später schützen und löschen.110
Die folgende Ampel ist eine redaktionelle Orientierung und ersetzt keine Bewertung im Einzelfall. Sie lehnt sich an die Ampel für KI-Werkzeuge in unserem Beitrag zu ChatGPT und Datenschutz an.
Tabelle seitlich scrollen
| Stufe | Beispiele | Was gilt |
|---|---|---|
| Grün | Handbücher, Vorlagen, Preislisten, Prozessbeschreibungen | Einbinden, sobald gültige Fassung und Zuständige feststehen |
| Gelb | Projekt- und Kundenunterlagen, Angebote, Verträge | Nur mit Rechtekonzept und Rechtsgrundlage für die enthaltenen Personendaten |
| Rot | Personalakten, Bewerbungen, Gesundheitsdaten | Erst nach gesonderter Bewertung, wenn überhaupt in einem getrennten Bereich |
Siehe auch
Welche KI-Zugänge für Firmendaten passenWie stellen Sie sicher, dass jeder nur sieht, was er sehen darf?
Das Sprachmodell selbst kann nicht unterscheiden, wer fragt. Laut Datenschutzkonferenz lässt sich im Modell nicht steuern, wer auf welche Informationen zugreifen darf. Die Rechte gehören deshalb in die Dokumente und in die Vektordatenbank.1
Dort helfen bewährte Mittel: ein Rechte- und Rollenkonzept und eine Trennung nach Abteilungen oder Mandanten. Nutzen Mitarbeitende das System für verschiedene Zwecke, brauchen sie dafür verschiedene Rollen. So bleibt etwa die Personalabteilung ein eigener Bereich, den der Vertrieb nicht abfragen kann.1
Ein fiktives Beispiel: Ein Vertriebsmitarbeiter fragt nach den Sonderkonditionen eines Kunden. Das System antwortet nur, wenn er auch ohne KI auf den Kundenordner zugreifen dürfte. Alle anderen erfahren, dass sie dafür keine passende Quelle haben.
Fertige Produkte lösen das unterschiedlich. Microsoft Copilot zeigt nur Unternehmensdaten, für die der jeweilige Nutzer mindestens Leserechte hat. Microsoft rät deshalb, die Berechtigungen in Diensten wie SharePoint sauber zu setzen, denn was heute zu großzügig freigegeben ist, findet Copilot auch.3
Langdock löst das bei synchronisierten Ordnern über das Konto des Nutzers. Mit jeder Anfrage prüft die Plattform, ob er die jeweilige Datei in der Quelle sehen darf.4
Siehe auch
Microsoft Copilot und DatenschutzWie belegt das System seine Antworten?
Mit einer Quellenangabe zu jeder Antwort. Laut Datenschutzkonferenz macht die Dokumentation der genutzten Quellen nachvollziehbar, auf welche Abschnitte oder Dokumente sich eine Antwort stützt. Ihr Team kann dann nachlesen, statt der Antwort blind zu vertrauen.1
Gängige Werkzeuge bieten das an. Open WebUI ergänzt Antworten aus Wissenssammlungen um Zitate mit Verweis auf die Fundstelle. Microsoft Copilot speichert die Zitate, auf die sich eine Antwort stützt, im Aktivitätsverlauf des Nutzers.36
Eine Quelle ersetzt trotzdem nicht den Blick eines Menschen. Geht eine Antwort nach außen, etwa in ein Angebot oder an einen Kunden, liest sie vorher jemand gegen. Auch Microsoft weist darauf hin, dass KI-Antworten nicht garantiert sachlich richtig sind.3
Welche KI-Wissensmanagement-Software passt zu Ihrem Betrieb?
Für KI-Wissensmanagement-Software gibt es drei Wege. Sie nutzen KI in der Bürosoftware, die Sie ohnehin haben, setzen eine KI-Plattform mit Wissensfunktion ein oder betreiben eine eigene Lösung. Wer nach einem eigenen ChatGPT für das Unternehmen sucht, landet meist bei einem dieser Wege. Die genannten Anbieter sind Beispiele, keine Empfehlung.
KI in der Bürosoftware, etwa Microsoft Copilot, greift auf E-Mails, Dokumente und Chats in Microsoft 365 zu und beachtet deren Rechte. Andere Systeme binden Sie über Konnektoren an. Für Kunden in der EU bleibt die Verarbeitung innerhalb der EU-Datengrenze von Microsoft, Modelle von Anthropic sind davon derzeit ausgenommen.3
Eine KI-Plattform wie Langdock verbindet Chat und eigene Assistenten mit Wissensordnern. Ordner aus SharePoint, Google Drive, OneDrive oder Confluence lassen sich anbinden und werden täglich aktualisiert. Für jedes Modell weist Langdock aus, ob es in der EU oder global betrieben wird.45
Bei der eigenen Lösung betreiben Sie eine Oberfläche wie Open WebUI mit eigener Wissensdatenbank, auf einem gemieteten Server oder im eigenen Haus. Wer welche Wissenssammlung lesen darf, legen Sie dort über Gruppen fest. Einrichtung, Updates und Sicherung liegen dann bei Ihnen oder Ihrem Dienstleister.67
Tabelle seitlich scrollen
| Kriterium | KI in Bürosoftware | KI-Plattform | Eigene Lösung |
|---|---|---|---|
| Beispiel | Microsoft Copilot | Langdock | Open WebUI mit eigener Vektordatenbank |
| Rechte | Übernimmt die Rechte aus Microsoft 365 | Prüft bei synchronisierten Ordnern die Rechte in der Quelle | Über Gruppen selbst festgelegt |
| Datenstandort | EU-Datengrenze für EU-Kunden, Anthropic-Modelle ausgenommen | Je Modell als EU oder global gekennzeichnet | Frei wählbar, auch im eigenen Haus |
| Grenzen | Inhalte aus Microsoft 365 und angebundenen Quellen | Höchstens 5 synchronisierte Ordner je Agent, 200 Dateien je Ordner, tägliche Aktualisierung | Betrieb, Updates und Sicherung liegen bei Ihnen |
| Passt für | Betriebe, die durchgehend mit Microsoft 365 arbeiten | Teams, die schnell starten und mehrere Modelle nutzen wollen | Hohe Anforderungen an Kontrolle, auch ohne Cloud |
Siehe auch
Werkzeuge, die Ihre Programme verbindenWas kostet ein internes KI-System?
Bei Plattformen zahlen Sie einen festen Preis pro Nutzer und Monat. Die Tabelle zeigt das am Beispiel von Langdock für ein Team von 25 Nutzern, mit den KI-Modellen im Preis.8
Bei der eigenen Lösung fällt der Server kaum ins Gewicht. Dazu kommen Gebühren für das Sprachmodell nach Verbrauch oder, beim Betrieb im Haus, eigene Hardware. Einrichtung und Pflege hängen stark von Umfang und Anforderungen ab, deshalb nennen wir dafür keine Pauschale.9
Die Preise stammen von den Seiten der Anbieter, abgerufen am 4. Oktober 2026. Sie verstehen sich zuzüglich Umsatzsteuer.89
Tabelle seitlich scrollen
| Posten | KI-Plattform | Eigene Lösung |
|---|---|---|
| Lizenz | 23,20 € pro Nutzer und Monat bei jährlicher, 29,00 € bei monatlicher Zahlung (Langdock Business mit KI-Modellen) | Je nach gewählter Software |
| 25 Nutzer jährlich | 6.960 € bei jährlicher Zahlung | Entfällt |
| Server | Im Preis enthalten | 19,49 € im Monat für einen Cloud-Server (Hetzner CPX22, ohne IPv4-Adresse) |
| Modellnutzung | Enthalten, mit Grenzen für faire Nutzung | Nach Verbrauch, beim Betrieb im Haus eigene Hardware |
| Einrichtung | Ordner anbinden, Rechte setzen, Team einweisen | Aufbau, Updates und Sicherung nach Aufwand |
Was verlangt der Datenschutz bei einem internen KI-System?
Zuerst eine Rechtsgrundlage. Liest das System Dokumente mit personenbezogenen Daten ein, verarbeitet es diese im Embedding-Modell und speichert sie in der Vektordatenbank. Dafür brauchen Sie nach Art. 6 DSGVO eine Grundlage, wie für jede andere Verarbeitung auch.110
Bei den Rechten der Betroffenen hilft RAG. Auskunft, Berichtigung und Löschung lassen sich für Eingaben, Antworten, Dokumente und Vektordatenbank in der Regel umsetzen. Einträge in der Datenbank sind direkt adressierbar, übliche Löschfristen lassen sich also auch hier umsetzen.110
Im Sprachmodell selbst ist die Umsetzung dieser Rechte laut Datenschutzkonferenz weitgehend ungelöst. Personenbezogene Daten sollten deshalb in Dokumenten und Datenbank bleiben und nicht in ein Modell hineintrainiert werden. Auch die Zweckbindung gehört schon in die Planung, denn Daten aus Ihren Dokumenten können sich im Modell mit dessen Trainingswissen verketten.1
Verarbeitet ein Anbieter Daten in Ihrem Auftrag, etwa in seiner Cloud, schließen Sie mit ihm einen Vertrag zur Auftragsverarbeitung nach Art. 28 DSGVO. Nach dem geänderten Art. 4 des AI Act ergreifen Sie außerdem Maßnahmen, die die KI-Kompetenz Ihres Teams unterstützen.1011
Siehe auch
Welche KI-Zugänge für Firmendaten passenWie halten Sie das Wissen aktuell?
Ein internes KI-System veraltet so schnell wie seine Dokumente. Die Datenschutzkonferenz verlangt deshalb, regelmäßig zu kontrollieren, ob die Unterlagen aktuell, richtig und vollständig sind. Vier Gewohnheiten helfen dabei.1
- Zuständige benennen: Jeder Wissensbereich hat eine Person, die seine Dokumente verantwortet.
- Löschen statt liegen lassen: Veraltete Fassungen verschwinden aus dem System, sobald eine neue gilt.
- Rückmeldungen nutzen: Markiert jemand eine Antwort als falsch, landet der Hinweis bei der zuständigen Person.
- Interne Quellen zuerst: Externe Inhalte kommen nur mit klarer Herkunft hinein und stehen hinter den eigenen Unterlagen.
Wie führen Sie ein internes KI-System in fünf Schritten ein?
Die Reihenfolge beginnt bei den Fragen Ihres Teams und endet bei der Pflege. In jedem Schritt bereitet das System vor, und ein Mensch entscheidet.
Fragen sammeln
- Das System bereitet vor
- Bündelt die Fragen, die das Team in einer kurzen Sammelphase einträgt, und ordnet sie nach Themen.
- Der Mensch entscheidet
- Wählt die Fragen aus, mit denen das System starten soll, am besten die häufigsten.
Dokumente auswählen und bereinigen
- Das System bereitet vor
- Findet Dubletten, veraltete Fassungen und störende Kopf- und Fußzeilen.
- Der Mensch entscheidet
- Entscheidet, welche Fassung gilt und was gelöscht wird.
Rechte abbilden
- Das System bereitet vor
- Übernimmt Gruppen und Ordnerrechte aus den vorhandenen Systemen.
- Der Mensch entscheidet
- Legt fest, welche Bereiche getrennt bleiben, etwa Personal oder Geschäftsführung.
Mit Testfragen erproben
- Das System bereitet vor
- Beantwortet die gesammelten Fragen mit Quellenangabe.
- Der Mensch entscheidet
- Bewertet jede Antwort. Erst wenn die Ergebnisse verlässlich sind, geht es weiter.
Freigeben und pflegen
- Das System bereitet vor
- Meldet Fragen ohne passende Quelle und Antworten, die als falsch markiert wurden.
- Der Mensch entscheidet
- Die Zuständigen ergänzen Dokumente, das Team wird eingewiesen.
Wie bauen wir bei AK eine interne Unternehmens-AI?
Handbücher, Vorlagen, Preislisten und Erfahrungswissen stecken in vielen Ordnern und Köpfen. Mit unserer Lösung „Interne Unternehmens-AI“ beantwortet ein System die Fragen Ihres Teams aus genau diesen Unterlagen. Sie bestimmen, welches Wissen es kennt, und auf Wunsch läuft es lokal bei Ihnen in der Firma.
Ein solches System ist eine Option, kein Pflichtteil jedes Projekts. Wir arbeiten nach dem Prinzip AI First: Wiederkehrende Aufgaben prüfen wir zuerst auf eine sichere technische Übernahme. Der Mensch bleibt dort, wo Urteil, Verantwortung oder eine Freigabe nötig sind.
Rechtliche, technische und datenschutzbezogene Anforderungen beziehen wir in den konkreten Aufbau ein, bevor etwas in Betrieb geht. Am Anfang steht die Frage, wo Ihr Team heute nach Antworten sucht. Im Erstgespräch klären wir, ob ein internes System dafür der passende Weg ist.
Quellen und Stand
Stand: 4. Oktober 2026. Dieser Beitrag bietet allgemeine Orientierung zu internen KI-Systemen in Unternehmen in Deutschland und ersetzt keine Rechtsberatung im Einzelfall. Anbieterangaben und Preise ändern sich häufig, wir aktualisieren sie vierteljährlich.
- 1Datenschutzkonferenz: Orientierungshilfe zu generativen KI-Systemen mit RAG-Methode (neuer Tab)
Version 1.0, Stand Oktober 2025. Abschnitt 2 und 2.1: Aufbau aus Datenaufbereitung, Embedding-Modell, Vektordatenbank, Retriever und Sprachmodell. Abschnitt 2.2: Grenzen. Abschnitt 3.1 bis 3.7: Richtigkeit, Transparenz, Vertraulichkeit, Zweckbindung, Löschung, Rechtsgrundlage, Betroffenenrechte. Vollständig gelesen am 04.10.2026.
- 2Berliner Beauftragte für Datenschutz: DSK veröffentlicht Orientierungshilfe zu RAG (neuer Tab)
Pressemitteilung vom 17.10.2025 zur Veröffentlichung der 18-seitigen Orientierungshilfe für Unternehmen und Behörden. Abgerufen am 04.10.2026.
- 3Microsoft Learn: Daten, Datenschutz und Sicherheit für Microsoft Copilot (neuer Tab)
Copilot zeigt nur Unternehmensdaten, für die Benutzer mindestens Anzeigeberechtigungen haben. Eingaben und Antworten nicht zum Training der Basismodelle. EU-Datengrenze, Anthropic-Modelle derzeit ausgenommen. Zitate im Aktivitätsverlauf. Microsoft 365 Copilot heißt jetzt Microsoft Copilot. Aktualisiert am 01.10.2026, abgerufen am 04.10.2026.
- 4Langdock Docs: Folder Sync (neuer Tab)
Ordner aus SharePoint, Google Drive, OneDrive und Confluence Cloud, tägliche Aktualisierung, Prüfung der Zugriffsrechte je Nutzer über dessen verbundenes Konto. Höchstens 5 synchronisierte Ordner je Agent oder Projekt, 200 Dateien je Ordner in der Cloud, 1.000 bei eigener Installation. Abgerufen am 04.10.2026.
- 5Langdock: KI-Modelle (neuer Tab)
Kennzeichnung je Modell, ob es in der EU oder global betrieben wird. Abgerufen am 04.10.2026.
- 6Open WebUI Docs: Retrieval Augmented Generation (neuer Tab)
Wissenssammlungen mit RAG, Zitate als Verweis auf die genutzten Dokumente, Anbindung lokaler und externer Embedding-Modelle. Abgerufen am 04.10.2026.
- 7Open WebUI Docs: Groups (neuer Tab)
Wissenssammlungen lassen sich privat stellen und gezielt Gruppen oder einzelnen Nutzern mit Lese- oder Schreibrecht freigeben. Abgerufen am 04.10.2026.
- 8Langdock: Preise (neuer Tab)
Business, Standardlizenz mit KI-Modellen bis 50 Nutzer: 23,20 € pro Nutzer und Monat bei jährlicher, 29,00 € bei monatlicher Zahlung, zuzüglich Umsatzsteuer, laut Preisrechner. Fair-Use-Grenzen für die enthaltenen Modelle. Abgerufen am 04.10.2026.
- 9Hetzner: Cloud-Server (neuer Tab)
Beispiel CPX22 mit 2 vCPU und 4 GB Arbeitsspeicher am Standort Nürnberg: 19,49 € netto im Monat ohne IPv4-Adresse, laut Preisdaten der Seite. Das entspricht den 23,19 € inklusive 19 % Umsatzsteuer aus der Preisanpassung vom 15.06.2026. Abgerufen am 04.10.2026.
- 10DSGVO: Artikel 5, 6, 9, 15 bis 17 und 28 (neuer Tab)
Grundsätze wie Richtigkeit und Datenminimierung, Rechtmäßigkeit der Verarbeitung, besondere Kategorien personenbezogener Daten, Auskunft, Berichtigung und Löschung, Auftragsverarbeitung. Wortlaut abgerufen am 04.10.2026.
- 11Digital Omnibus zur KI: Verordnung (EU) 2026/1744 (neuer Tab)
Vom 08.07.2026, veröffentlicht am 24.07.2026, in Kraft seit 27.07.2026. Neuer Art. 4: Maßnahmen, um die Entwicklung der KI-Kompetenz des Personals zu unterstützen, ohne für eine Person ein bestimmtes Niveau zu garantieren. Abgerufen am 04.10.2026.